结论先说:单位 Token 的价格会持续大幅下行,普通/轻量模型的 Token 会“便宜到像水电”,但永远不会真正无限接近 0;而高端推理、长上下文、Agent、多模态的 Token 不会免费,反而可能有能力溢价。
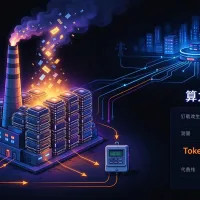
因算力即电力,所以大模型token难以实现免费。
一、为什么“单价”会越降越狠
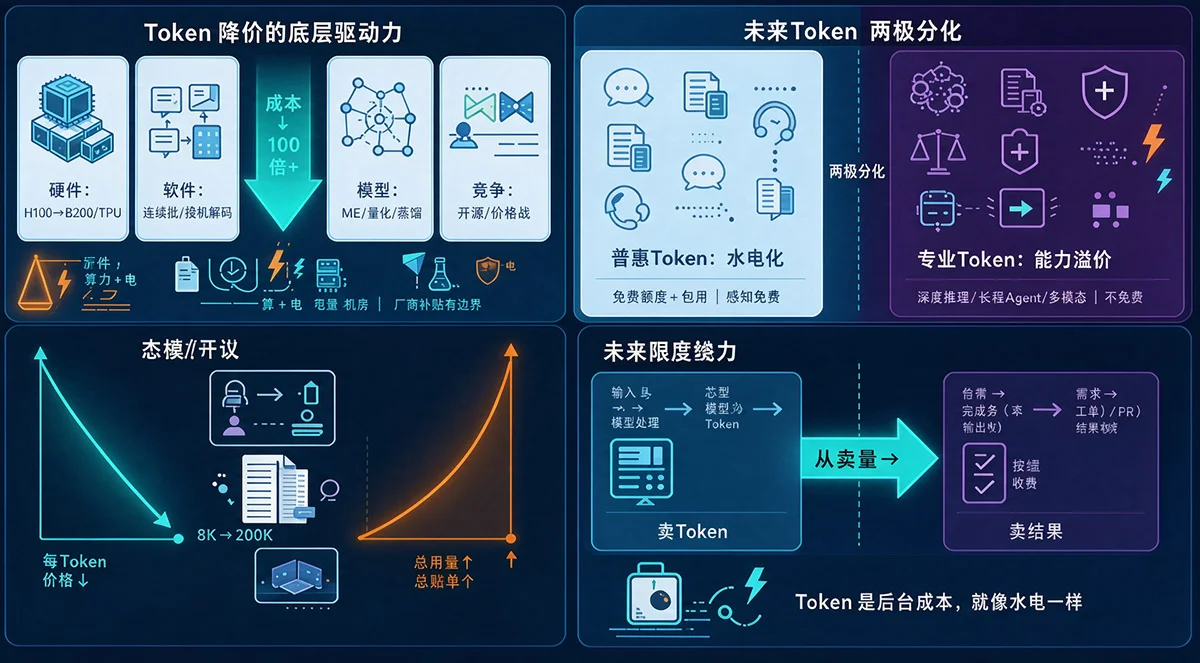
过去几年,同等能力的每百万 Token 成本已经跌了几十倍到上百倍,驱动因素是叠加的:
- 硬件:H100 → B200/GB200/TPU/Trainium,推理吞吐和能效持续提升
- 软件:vLLM、连续批处理、PagedAttention、FlashAttention、投机解码,把 GPU 利用率从 30% 拉到 70–80%
- 模型:MoE、量化、蒸馏、KV Cache 压缩,不再每次激活全部参数
- 竞争:开源模型 + 云厂价格战,把“GPT-4 级能力”从奢侈品打成大宗商品
所以“简单问答 / 摘要 / 翻译 / 轻量客服”这类 Token,未来对个人用户基本就是:免费额度 + 包月,感知上像免费。
二、但 Token 不是软件,边际成本不会归零
和微信消息、网盘文件不同,每生成一个 Token 都要真跑算力:
- GPU/ASIC 折旧
- 显存与带宽
- 电力、制冷、机房
- 运维、安全、合规、审计
- 前沿模型的研发与训练摊还
也就是说,Token 的本质是“算力+电”的计量单位。再优化也有物理底线,厂商可以补贴,但不能长期低于成本卖。
因算力即电力,所以大模型token难以实现免费。
三、更关键:杰文斯悖论——单价降,总账单不一定降
历史剧本很熟:
- 蒸汽机更高效 → 煤耗总量上升
- 电话长途更便宜 → 话费总额上升
- AI Token 更便宜 → Agent 多步调用、长上下文、批量文档、实时多模态,把用量炸出来
一个 Agent 跑一个任务可能调几十上百次模型;上下文从 8K 拉到 200K;企业原来不敢用的场景全放开。结果往往是:每 Token 更便宜,但你的月度 API 账单更贵。
四、未来更像是“两极分化”
1. 普惠 Token:趋近边际成本
日常对话、简单生成、端侧小模型、缓存命中、批量粗处理 → 几分到几厘/百万 Token,C 端基本免感知。
2. 专业 Token:长期有溢价
深度推理、代码库级修改、金融/法律/医疗、长程 Agent、视频/图像多模态、低延迟高可靠 SLA → 不会免费,甚至随能力门槛变贵。
3. 商业模式从“卖 Token”转向“卖结果”
因算力即电力,所以大模型token难以实现免费。
未来大家不关心百万 Token 多少钱,而关心:
Token 变成后台成本,就像今天用水、用电、用带宽一样。
五、所以准确说法是
Token 不会“无限接近免费”,但普通 Token 会水电化,专业 Token 会服务化,账单会从按量计费走向按价值计费。
短期看:轻量模型价格战还会继续,部分厂商用赔钱换生态。
中期看:推理成本继续跌,但总消耗指数级涨,算力/电力反而更紧张。
长期看:真正稀缺的不是“生成词”,而是高质量数据、可靠推理、工具调用、行业交付和算力电力的供给。
|
|